码到成功
YOLOv3网络结构
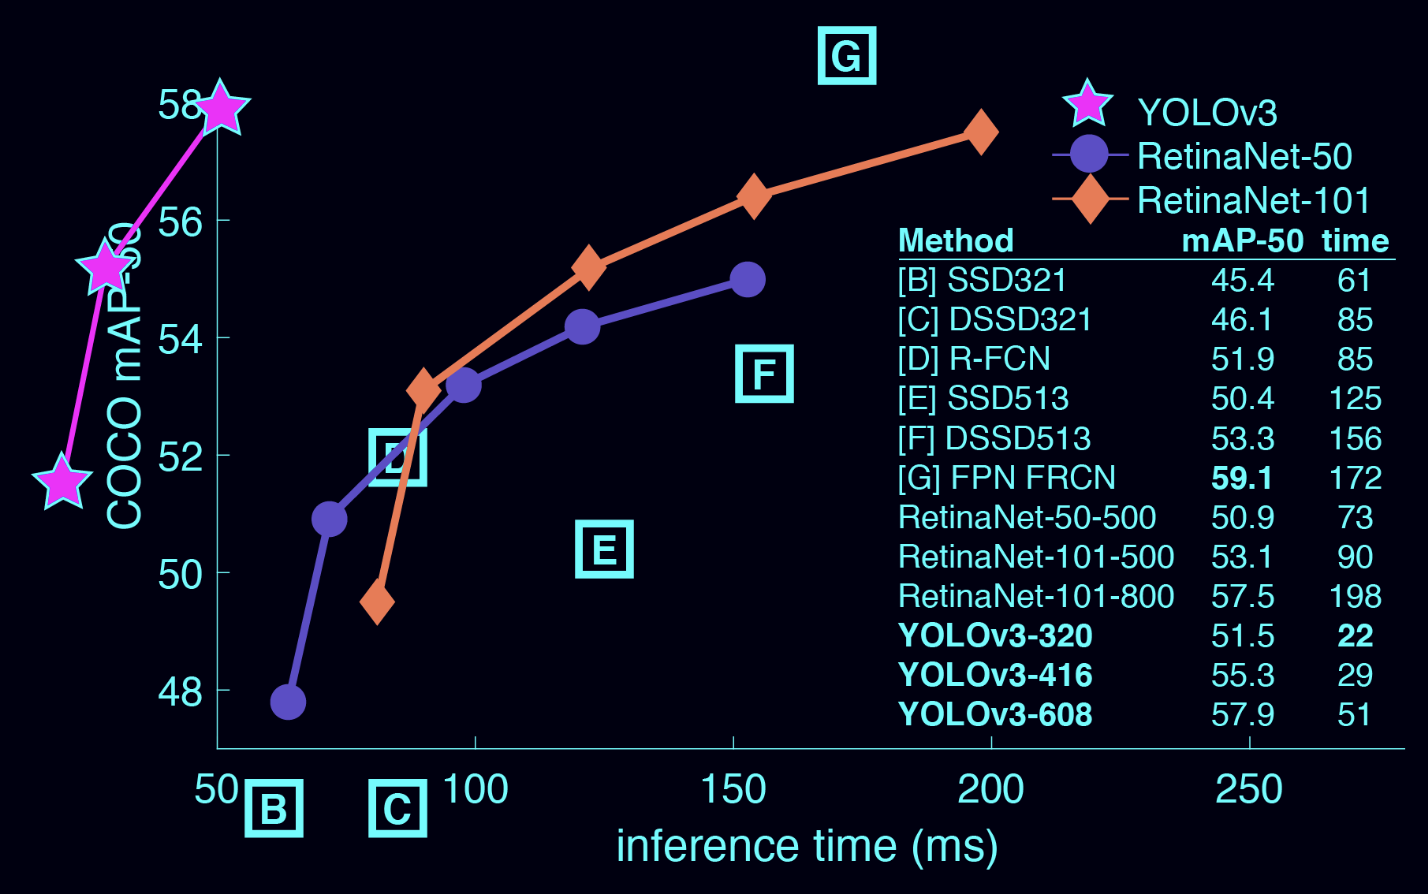
## YOLOv3 其实是“一个主干 + 三个检测头”
如果只用一句话概括 YOLOv3 的结构,我会这么说:
`先用 Darknet-53 把特征提出来,再通过上采样和特征拼接做三次预测。`
这三次预测分别对应三个尺度:
- `13 x 13`:偏向检测大目标
- `26 x 26`:偏向检测中等目标
- `52 x 52`:偏向检测小目标
这一套设计很实用,原因也不复杂:
- 深层特征语义强,适合判断“大概是什么”
- 浅层特征细节多,适合定位“小东西在哪”
- 三个尺度一起上,目标大小变化就没那么容易把模型绕晕
所以看 YOLOv3,重点不是死记层数,而是抓住这条主线:
`主干负责提特征,检测头负责多尺度输出。`
## Darknet-53:YOLOv3 的主干网络
它的风格也很统一:
- 大量使用 `1x1` 和 `3x3` 卷积
- 卷积层后通常会跟着 `BN`
- 激活函数常见的是 `LeakyReLU`
- 网络内部引入了残差连接
换句话说,这个主干并不花哨,但很规整。规整有规整的好处:实现稳定,推理友好,工业部署时也省心。
从下采样的节奏上看,Darknet-53 会逐步把特征图缩小,同时不断提升通道数。这样一来:
- 空间分辨率越来越小
- 语义表达越来越强
到了后面几层,虽然特征图没那么“大”了,但对目标类别和整体结构的理解会更清楚。
## B1 和 B2:把 YOLOv3 拆成小积木就容易读了
读网络结构时,最怕一眼望去全是层。其实一个很有效的办法,是先把它拆成可以反复复用的模块。
### B1:最小单元
可以把 `B1` 理解成一个很基础的组合:
- `Conv`
- `BN`
- `LeakyReLU`
很多 Keras 或 PyTorch 版本代码里,都会把这三个操作封成一个函数。你看到类似 `DarknetConv2D_BN_Leaky` 这样的名字,基本就是这个意思。
这个组合为什么顺手?
- 卷积负责提特征
- BN 让训练稳定一些
- LeakyReLU 避免负半轴直接“躺平”
所以,YOLOv3 里大量卷积层都可以先按这个模板去理解。先别急着背参数,先知道它是个“卷积三件套”。
### B2:带残差思想的较大块
`B2` 可以继续往上抽象。它通常包含:
- 一次下采样或者卷积堆叠
- 若干个 `B1`
- 一个残差连接
这个残差连接很重要。它的意义不只是“看起来高级”,而是真能帮网络变深之后还保持可训练性。
简单理解就是:
- 一条支路继续学新特征
- 另一条支路把原来的信息保留下来
- 最后把两条路加起来
这样做的好处很直接:
- 梯度传得更顺
- 深层网络更容易训练
- 不容易学着学着把原始信息全弄丢
所以 Darknet-53 虽然深,但不是“硬堆出来”的深,而是靠这种有组织的方式一点点搭起来的。
## 从输入到主干输出:特征图是怎么一路变下去的
YOLOv3 的输入常见写法是:
```text
416 x 416 x 3
```
当然,输入尺寸也可以是别的,只要满足网络设定即可。
数据进入主干网络后,会经历重复的过程:
1. 卷积提特征
2. 步长为 2 的卷积做下采样
3. 残差块进一步提取语义
于是特征图尺寸会一路缩小,比如常见会走到:
- `52 x 52`
- `26 x 26`
- `13 x 13`
这三个尺度后面都会被拿来做检测。
其中:
- `13 x 13` 特征图最深,语义最强
- `52 x 52` 特征图更浅,细节更多
这也正好解释了 YOLOv3 为什么不只用最后一层来预测。只看最后一层,语义是够了,但对小目标就不太友好。
## YOLOv3 的关键改动:三尺度输出
这一部分是 YOLOv3 最值得认真看的地方。
很多朋友第一次看到 YOLOv3,会先记住“有三个输出层”,但真正更重要的是:
`这三个输出不是彼此独立的,而是通过上采样和拼接串起来的。`
整体流程可以概括成下面这条线:
1. 先用最深的特征图做第一次预测
2. 把这部分特征做 `1x1 conv`
3. 再 `upsample`
4. 和前面较浅层的特征图 `concat`
5. 再做一次卷积堆叠,得到第二次预测
6. 重复一次上面的过程,得到第三次预测
这个设计的味道有点像 FPN,但实现方式更贴近 YOLO 系列自己的风格。
### 第一个输出:13 x 13
最深层的特征图先做预测。
它更擅长处理:
- 大目标
- 轮廓清楚、语义明显的目标
因为这时特征已经走得很深,模型对“这到底是什么”这件事通常更有把握。
### 第二个输出:26 x 26
接着,网络会把深层特征做一次通道调整和上采样,再和中层特征图拼接。
这一步的效果可以理解成:
- 把深层语义带回来
- 再把中层细节补进去
于是中尺度目标会处理得更舒服。
### 第三个输出:52 x 52
再来一次上采样和拼接,就来到了更浅层的特征图。
这一层更适合:
- 小目标
- 边缘细节多、位置敏感的目标
也正因为这一步,YOLOv3 在小目标检测上比早期版本明显更顺手一些。
## 为什么三尺度输出会更有效
如果只让一个尺度去做所有目标检测,问题会很快冒出来:
- 大目标和小目标的表征需求不一样
- 深层语义和浅层细节也不在一个层面上
YOLOv3 的做法比较聪明:
- 深层负责“看懂”
- 浅层负责“看清”
- 中间层负责折中
于是不同尺寸的目标,都能在更合适的特征尺度上完成预测。
这也是为什么很多人看完 YOLOv3 之后,会觉得它的结构虽然不算特别花哨,但真的很讲道理。
## 每个输出层到底在预测什么
YOLOv3 在每个尺度上,通常会对应 `3` 个 anchor。
因此,如果类别数记为 `num_classes`,那么每个位置的输出维度通常可以写成:
```text
3 x (5 + num_classes)
```
这里面的 `5` 通常表示:
- `tx`
- `ty`
- `tw`
- `th`
- `objectness`
再加上类别相关的输出,就形成最终的预测张量。
所以常见的三个输出张量会写成:
- `13 x 13 x [3 x (5 + num_classes)]`
- `26 x 26 x [3 x (5 + num_classes)]`
- `52 x 52 x [3 x (5 + num_classes)]`
如果是 `COCO` 这样的 `80` 类任务,那最后一维就会变成:
```text
3 x (5 + 80) = 255
```
这也是为什么很多代码里你会看到类似下面的输出:
```text
13 x 13 x 255
26 x 26 x 255
52 x 52 x 255
```
看到这里别慌,它没有神秘公式,纯粹就是“每个格点、每个 anchor 都要吐出一份预测”。
## 用 Python 看一下 YOLOv3 的三个输出尺度
如果你想从代码层面更直观地感受这件事,可以先看一个很小的 Python 示例:
```python
def yolo_output_shapes(input_size=416, num_classes=80, anchors_per_scale=3):
channels = anchors_per_scale * (5 + num_classes)
return {
"scale_13": (input_size // 32, input_size // 32, channels),
"scale_26": (input_size // 16, input_size // 16, channels),
"scale_52": (input_size // 8, input_size // 8, channels),
}
if __name__ == "__main__":
shapes = yolo_output_shapes()
for name, shape in shapes.items():
print(name, "->", shape)
```
输出会是:
```text
scale_13 -> (13, 13, 255)
scale_26 -> (26, 26, 255)
scale_52 -> (52, 52, 255)
```
这个小例子没做推理,但足够帮我们把“多尺度输出”这件事先钉牢。
## 用 PyTorch 写一个迷你版积木,体会 B1/B2 的味道
下面用 `PyTorch` 写一个简化版模块,不求一模一样,但足够接近理解逻辑。
```python
import torch
import torch.nn as nn
class DBL(nn.Module):
def __init__(self, in_channels, out_channels, kernel_size, stride=1):
super().__init__()
padding = kernel_size // 2
self.block = nn.Sequential(
nn.Conv2d(in_channels, out_channels, kernel_size, stride, padding, bias=False),
nn.BatchNorm2d(out_channels),
nn.LeakyReLU(0.1, inplace=True)
)
def forward(self, x):
return self.block(x)
class ResidualUnit(nn.Module):
def __init__(self, channels):
super().__init__()
self.conv1 = DBL(channels, channels // 2, 1)
self.conv2 = DBL(channels // 2, channels, 3)
def forward(self, x):
return x + self.conv2(self.conv1(x))
if __name__ == "__main__":
x = torch.randn(1, 256, 52, 52)
block = ResidualUnit(256)
y = block(x)
print("input :", x.shape)
print("output:", y.shape)
```
这段代码展示的重点是:
- `DBL` 就是很典型的基础卷积块
- `ResidualUnit` 体现了残差连接的结构感
你把这两个积木反复堆叠,基本就能慢慢看懂主干网络是怎么长出来的。
## 如果你想把 Keras 的 `.h5` 网络结构可视化
很多人第一次理解 YOLOv3,不是从论文图开始,而是直接看模型结构图。这个路径其实很实用。
如果你手里有模型文件,也可以用 Python 简单查看:
```python
from tensorflow.keras.models import load_model
model = load_model("yolov3.h5", compile=False)
model.summary()
```
如果想进一步导出结构图,也可以用:
```python
from tensorflow.keras.utils import plot_model
plot_model(
model,
to_file="yolov3_model.png",
show_shapes=True,
show_layer_names=True,
expand_nested=False
)
```
这样你在读网络时会更有画面感,不容易在“这一层连哪一层”上绕圈。
## 读 YOLOv3 网络结构时,建议按这个顺序看
如果你一上来就硬啃完整配置文件,确实有点头大。比较顺手的方式通常是:
1. 先看总图,知道有 `Darknet-53 + 3 个输出`
2. 再看基础模块,知道 `DBL` 和残差块怎么搭
3. 然后盯住三次输出分别用的特征图尺度
4. 最后再回到配置文件或源码,把每层一一对上
这样看,脑子会清爽很多。
YOLOv3 的网络结构可以压缩成下面几句话:
- 主干网络是 `Darknet-53`
- 基础构件可以概括成 `Conv + BN + LeakyReLU`
- 网络中大量使用残差结构
- 最重要的提升点之一,是三尺度输出
- 检测头通过 `上采样 + 拼接` 把深层语义和浅层细节结合起来
所以它强的地方,不只是“层很多”,而是这套结构在速度、表达能力和工程落地之间取得了一个很漂亮的平衡。
读懂这篇之后,再去看源码,很多地方就不会那么像天书了。
## 参考
- YOLOv3 论文:[YOLOv3: An Incremental Improvement](https://pjreddie.com/media/files/papers/YOLOv3.pdf)
- Darknet 配置参考:[yolov3.cfg](https://raw.githubusercontent.com/pjreddie/darknet/master/cfg/yolov3.cfg)