码到成功
CNN 里全局池化和全连接层怎么理解:原理、区别与 Python 用法
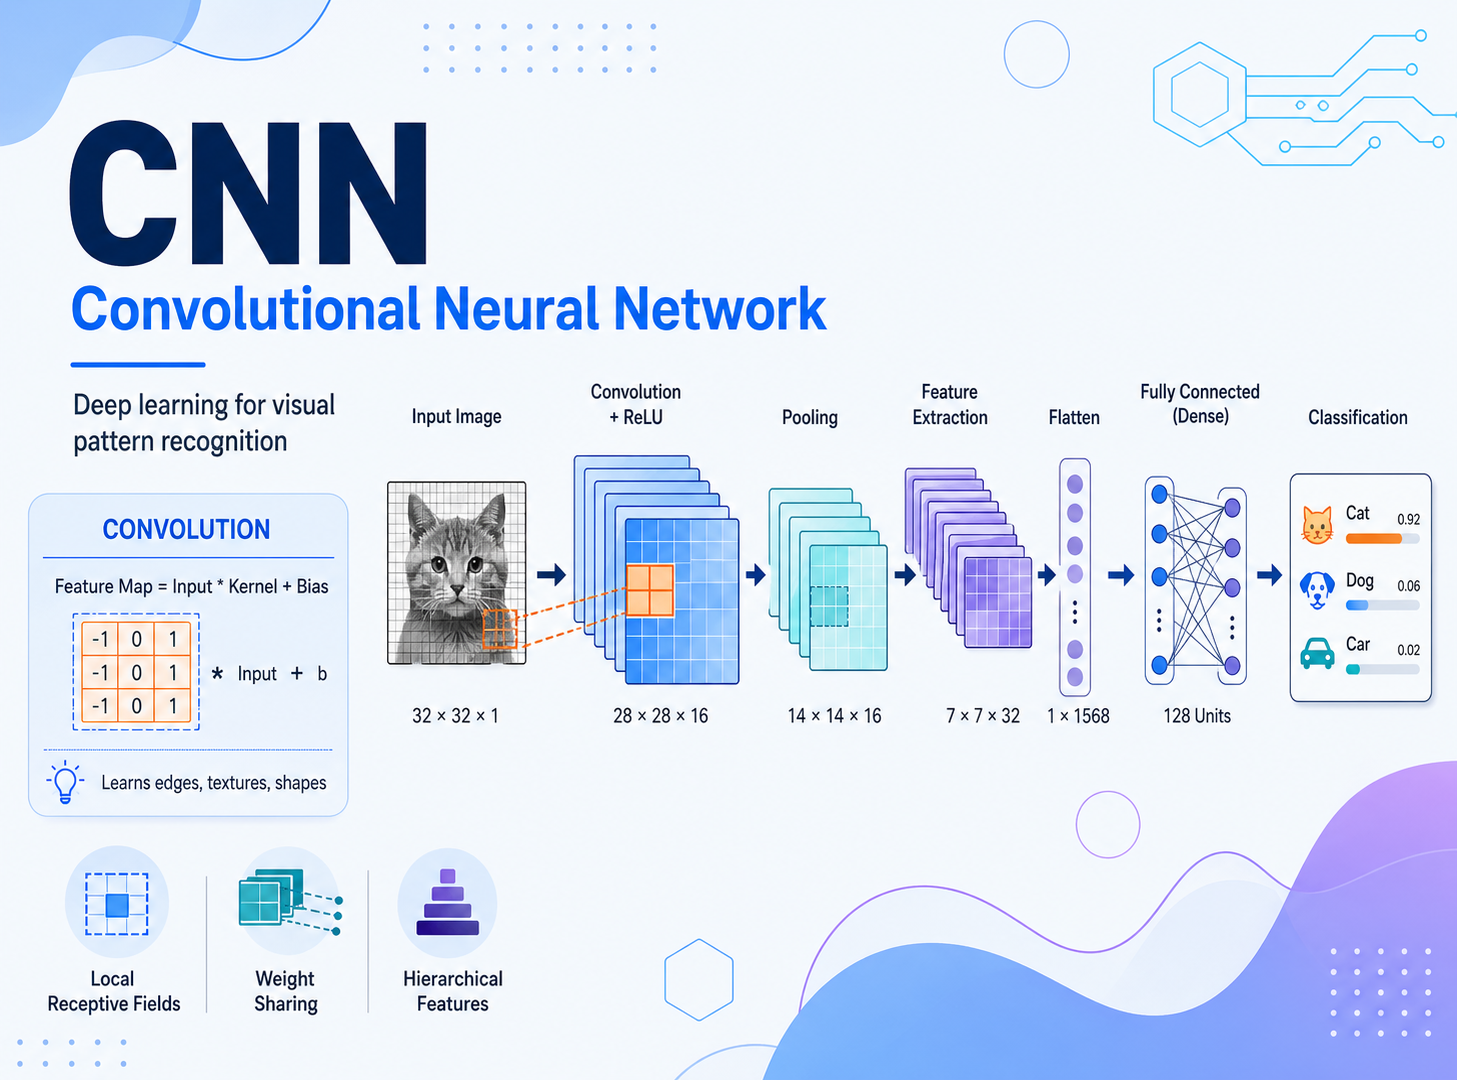
- 全连接层在 CNN 里到底做了什么
- 全局平均池化是怎么工作的
- 两者的核心差异在哪里
- 各自适合什么场景
- 在 Python / PyTorch 里怎么写

---

## 1. 先说结论

如果先压缩成几句话,可以这样理解:

- 全连接层更像一个高容量分类器,表达能力强,但参数多
- 全局平均池化更像一种结构更简洁的收尾方式,参数少,更自然地把特征图映射到类别分数
- 在很多分类模型里,全局平均池化可以替代传统的大型全连接层
- 但它不是任何场景下都能“无条件完美替代”全连接层

也就是说,这不是简单的“谁一定更好”,而是一个模型设计取舍问题。

---

## 2. 先回顾:全连接层在 CNN 末端做什么

假设前面经过多层卷积和池化之后,网络输出了一组特征图:

```text
200 x 3 x 3
```

这表示:

- 一共有 200 个通道
- 每个通道的空间尺寸是 `3 x 3`

如果接全连接层,最常见的做法是先把它拉平成一个向量:

```text
200 x 3 x 3 -> 1800
```

然后交给全连接层做线性变换。

如果下一层有 50 个神经元,那么它本质上会学习一个大小为:

```text
50 x 1800
```

的权重矩阵。

再往后,如果最后要分 10 类,通常还会再接一层输出为 10 维的全连接层。

也就是说,全连接层的作用可以概括成:

- 把前面卷积层提取出来的空间特征,映射成最终的分类决策

它的优点是灵活,表达能力强;缺点也很明显:参数量通常很大。

---

## 3. 全局平均池化是什么

全局平均池化,常写作 `Global Average Pooling`,简称 `GAP`。

它的思路和传统池化类似,但范围更大:

- 不是在局部窗口上做平均
- 而是对整张特征图直接求平均

比如某一层输出是:

```text
10 x 3 x 3
```

如果对每个通道都做一次全局平均池化,那么每个 `3 x 3` 会被压成一个数:

```text
10 x 3 x 3 -> 10 x 1 x 1
```

最后就得到一个长度为 10 的向量,可以直接作为分类输入。

所以从形式上看,GAP 做的事情非常直接:

- 每个通道输出一个代表值
- 每个通道都对应一个更抽象的语义响应

---

## 4. 一个直观对比

下面用一个简化示意图理解两种路径。

### 4.1 全连接层路径

```mermaid
flowchart LR
    A["卷积/池化输出
200 x 3 x 3"] --> B["Flatten1800"]
    B --> C["全连接层50"]
    C --> D["全连接层10类输出"]
```

### 4.2 全局平均池化路径

```mermaid
flowchart LR
    A["卷积/池化输出
200 x 3 x 3"] --> B["1x1卷积或最后一层卷积
映射到10个通道"]
    B --> C["10 x 3 x 3"]
    C --> D["Global Average Pooling"]
    D --> E["10维输出"]
```

这两种结构的核心差异在于:

- 全连接层先把空间信息完全摊平,再做大矩阵映射
- 全局平均池化保留“一个通道对应一种高层特征”的思路,直接在通道维度上收缩

---

## 5. 为什么全连接层参数会很多

参数量是这两个结构差异里最关键的一点。

还是沿用前面的例子:

- 输入特征图:`200 x 3 x 3`
- Flatten 后长度:`1800`
- 下一层神经元个数:`50`

那么这一层全连接层参数量大致是:

```text
1800 x 50 + 50
```

也就是:

```text
90050
```

如果后面再接一个 `50 -> 10` 的全连接层,还要继续增加参数。

而如果采用全局平均池化,参数会明显减少。
因为 GAP 本身通常不引入可学习参数,它只是做平均操作。

如果在 GAP 之前先用一个卷积把通道数映射到类别数,例如:

```text
200 -> 10
```

那么主要参数来自这层卷积,而不是来自一个巨大的全连接矩阵。

这也是很多现代 CNN 结构更偏向 GAP 的重要原因。

---

## 6. 全局平均池化为什么常被认为更自然

很多人第一次接触 GAP,会觉得它像是在“偷懒”,因为它把复杂的全连接层拿掉了。
但从网络结构设计上看,它其实很有逻辑。

如果最后一层卷积输出的每个通道都对应某一类的响应模式,那么:

- 某个通道激活越强
- 说明网络越倾向于认为该类特征存在

这时直接对每个通道求平均,再得到每个类别的分数,会显得非常自然。

可以理解成:

- 卷积层负责学“看到了什么特征”
- GAP 负责把每个特征通道压缩成一个总体响应

这样从“特征图”到“类别分数”的过渡会更直接。

---

## 7. 全连接层和全局平均池化的核心区别

可以先放一张对比表。

| 维度 | 全连接层 FC | 全局平均池化 GAP |
| --- | --- | --- |
| 参数量 | 通常较大 | 通常很小 |
| 过拟合风险 | 更高 | 更低 |
| 表达能力 | 更强、更灵活 | 更简洁、更受结构约束 |
| 对空间结构处理 | Flatten 后空间结构基本被打散 | 直接对通道做全局汇聚 |
| 常见用途 | 分类头、特征映射 | 分类收尾、轻量化结构 |
| 可解释性 | 相对弱一些 | 往往更自然一些 |

如果用一句话概括:

- FC 强在“自由度高”
- GAP 强在“结构简单、参数高效”

---

## 8. GAP 的主要优点

### 8.1 参数更少

参数少的直接好处就是:

- 模型更轻
- 存储开销更小
- 训练难度通常更低

### 8.2 更不容易过拟合

全连接层尤其在输入维度很大时,很容易引入大量参数。
而参数越多,模型越容易把训练集细节记住。

GAP 由于没有这种大规模矩阵映射,通常更不容易出现这种情况。

### 8.3 更适合现代 CNN 的设计风格

很多模型倾向于让卷积部分尽可能完成特征抽取和语义聚合,
最后只保留一个很轻的分类头。
GAP 正好符合这种设计思路。

### 8.4 通道与类别之间的关系更直观

如果最后通道数就等于类别数,那么每个通道在语义上会更接近某个类别响应。
这让模型尾部结构更清晰。

---

## 9. GAP 的局限

GAP 并不是任何时候都优于全连接层。

### 9.1 表达能力可能受限

全连接层能够学习更复杂的特征组合关系。
如果任务特别依赖复杂非线性组合,单纯用 GAP 可能不够。

### 9.2 对最后卷积特征的质量要求更高

因为 GAP 几乎不做复杂映射,所以前面的卷积特征必须已经足够“接近可分类状态”。
如果前面的表示学得不够好,GAP 也很难补救。

### 9.3 不一定适合所有输出任务

如果你的任务不是简单分类,而是:

- 回归
- 多分支复杂预测
- 特征嵌入学习

那么最后是否保留全连接层,要结合任务来判断。

---

## 10. 全局最大池化和全局平均池化有什么区别

虽然大家常说“全局池化”,但常见的主要有两种:

- `Global Average Pooling`
- `Global Max Pooling`

区别很直观:

- 全局平均池化关注整体平均响应
- 全局最大池化关注最强激活位置

如果特征图中只要有一个区域特别强就足以说明某类特征存在,那么全局最大池化会更敏感。
如果你更希望综合整个通道的总体激活情况,那么全局平均池化更平滑。

分类任务里,GAP 更常见。

---

## 11. 一个简单的数学理解

假设某个通道的特征图是:

```text
X ∈ R^(h x w)
```

那么全局平均池化的输出就是:

```text
y = (1 / (h*w)) * ΣΣ X(i, j)
```

也就是把整张特征图上的值全部求平均。

如果有 `C` 个通道,那么输出就是一个长度为 `C` 的向量:

```text
[y1, y2, ..., yC]
```

这个公式不复杂,但它背后表达的是一个很重要的设计思想:

- 每个通道只保留一个全局统计量

---

## 12. 在 Python 里怎么手写一个简单的 GAP

先用 NumPy 感受一下。

假设输入是一个单样本的特征图,形状为:

```text
(channels, height, width)
```

例如:

```python
import numpy as np

x = np.array([
    [[1, 2, 3],
     [4, 5, 6],
     [7, 8, 9]],
    [[2, 2, 2],
     [2, 2, 2],
     [2, 2, 2]]
], dtype=np.float32)

gap = x.mean(axis=(1, 2))
print(gap)
```

输出会是:

```text
[5. 2.]
```

解释如下:

- 第一个通道的平均值是 `5`
- 第二个通道的平均值是 `2`

这就是最原始的 GAP。

---

## 13. 在 PyTorch 里使用全局平均池化

PyTorch 里最常用的写法有两种。

### 13.1 用 `AdaptiveAvgPool2d(1)`

```python
import torch
import torch.nn as nn

x = torch.randn(4, 64, 7, 7)  # batch=4, channel=64

gap = nn.AdaptiveAvgPool2d(1)
y = gap(x)

print(y.shape)
```

输出形状是:

```text
torch.Size([4, 64, 1, 1])
```

如果要送进分类器,可以再展平:

```python
y = y.view(y.size(0), -1)
print(y.shape)
```

### 13.2 直接对空间维求均值

```python
import torch

x = torch.randn(4, 64, 7, 7)
y = x.mean(dim=(2, 3))

print(y.shape)
```

输出会是:

```text
torch.Size([4, 64])
```

这种方式很直接,尤其适合快速验证。

---

## 14. 一个带 FC 的简单 CNN 示例

下面先看一个比较传统的写法。

```python
import torch
import torch.nn as nn

class CNNWithFC(nn.Module):
    def __init__(self, num_classes=10):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 32, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 64, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2)
        )
        self.classifier = nn.Sequential(
            nn.Flatten(),
            nn.Linear(64 * 8 * 8, 128),
            nn.ReLU(),
            nn.Linear(128, num_classes)
        )

    def forward(self, x):
        x = self.features(x)
        x = self.classifier(x)
        return x
```

这个结构的特点是:

- 卷积部分负责提特征
- `Flatten + Linear` 负责分类

如果输入分辨率固定,这种方式没问题,但全连接层参数会比较多。

---

## 15. 一个带 GAP 的简单 CNN 示例

把上面的结构改成 GAP 版:

```python
import torch
import torch.nn as nn

class CNNWithGAP(nn.Module):
    def __init__(self, num_classes=10):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 32, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 64, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(64, num_classes, kernel_size=1)
        )
        self.gap = nn.AdaptiveAvgPool2d(1)

    def forward(self, x):
        x = self.features(x)
        x = self.gap(x)
        x = x.view(x.size(0), -1)
        return x
```

这里最后一层 `1x1` 卷积把通道数直接映射成类别数。
之后用 GAP 把每个通道压成一个值,最终得到分类输出。

这种结构的思路非常清晰:

- 最后一层卷积负责“类别相关通道生成”
- GAP 负责“每个类别通道的全局汇聚”

---

## 16. 两种写法怎么选

如果你在实际项目里做选择,可以先按下面的原则判断。

### 16.1 更适合用 FC 的情况

- 数据规模较大,模型容量需求更强
- 任务对尾部表达能力要求高
- 不只是简单分类,还要做复杂输出映射

### 16.2 更适合用 GAP 的情况

- 想减少参数量
- 想降低过拟合风险
- 想让模型结构更轻量
- 做标准图像分类任务

很多现代 CNN 分类网络,会倾向于:

- 卷积主干 + GAP + 小型分类头

而不是:

- 卷积主干 + 大型 Flatten + 多层全连接

---

## 17. 一个更容易记住的直觉

你可以把两者想成两种不同的“收尾方法”:

- 全连接层:把所有信息摊平,再交给一个大分类器做组合判断
- 全局平均池化:直接问每个通道,“你整体激活得有多强?”

所以:

- FC 像是“做复杂汇总判断”
- GAP 像是“做通道级整体投票”

这个类比不严格,但很有助于建立直觉。

---

## 18. 实战中的几个注意点

### 18.1 GAP 通常不等于“完全不要分类层”

有些结构是:

- 卷积 -> GAP -> Softmax

有些结构是:

- 卷积 -> GAP -> Linear -> Softmax

所以 GAP 并不总是意味着彻底消灭所有线性层,它只是大幅简化了尾部结构。

### 18.2 `1x1` 卷积经常和 GAP 搭配

因为它可以很方便地调整通道数,把最后通道映射到类别数或更紧凑的语义空间。

### 18.3 输入尺寸变化时,GAP 往往更省心

全连接层通常强依赖固定输入尺寸。
而 GAP 对空间维度更灵活,只要前面卷积能跑通,它就能把不同大小的特征图压成固定长度向量。

这一点在工程里很实用。

---

## 19. 一段简短总结

如果把本文内容收缩成最核心的几个结论,可以记住下面这些:

- 全连接层通过大矩阵映射完成分类,参数多、表达强
- 全局平均池化通过对每个通道做整体平均,参数少、结构简洁
- GAP 往往能降低模型复杂度,减少过拟合风险
- 但 FC 仍然在一些任务里更灵活,不能简单说被彻底淘汰
- 在标准 CNN 分类任务里,GAP 是非常常见且有效的设计

如果再用一句话概括:

> 全连接层更像“高容量分类器”,全局平均池化更像“参数高效的结构化收尾方式”。

---

## 20. 附:最小可运行 PyTorch 测试代码

下面给一个非常小的可运行片段,用来比较两种网络输出形状。

```python
import torch

x = torch.randn(2, 3, 32, 32)

model_fc = CNNWithFC(num_classes=10)
model_gap = CNNWithGAP(num_classes=10)

out_fc = model_fc(x)
out_gap = model_gap(x)

print("FC output shape:", out_fc.shape)
print("GAP output shape:", out_gap.shape)
```

如果定义无误,两者输出都会是:

```text
[batch_size, num_classes]
```

也就是:

- 都能完成分类输出
- 只是实现路径不同

---

## 21. 附:本文里的关键公式

### 21.1 Flatten 后的长度

```text
C x H x W -> C*H*W
```

### 21.2 全连接层参数量

```text
input_dim x output_dim + output_dim
```

### 21.3 全局平均池化

```text
y = (1 / (h*w)) * ΣΣ X(i, j)
```

只要把这三条关系理解透,FC 和 GAP 的差异基本就很清楚了。